Biais de genre en santé et en intelligence artificielle
Pourquoi ce texte
C'est ce genre de situation qui m'a décidé à écrire ce texte. L'expression « biais de genre » est devenue omniprésente dans les débats sur l'intelligence artificielle en santé, et cette diffusion rapide a un coût : le terme désigne tantôt des discriminations avérées, tantôt n'importe quelle différence observée entre hommes et femmes. Deux erreurs symétriques en découlent. La première consiste à voir des biais partout — toute différence de prise en charge deviendrait suspecte, y compris celles que la biologie ou l'épidémiologie justifient pleinement. La seconde consiste à n'en voir nulle part : puisque les hommes et les femmes diffèrent réellement sur le plan médical, toute disparité constatée serait le simple reflet de la nature.
Ces deux lectures sont fausses, et elles le sont pour la même raison : elles confondent la différence et le biais. La grossesse n'est pas un biais de genre. La moindre fréquence des pathologies cardiovasculaires chez la femme adulte jeune non plus. En revanche, qu'une femme victime d'un infarctus soit plus souvent mal diagnostiquée qu'un homme, ou qu'elle reçoive moins d'antalgiques à intensité de douleur égale, en est un — mesuré, publié, reproductible. Je propose ici au lecteur non spécialiste les définitions et les critères qui permettent de faire cette distinction, en m'appuyant exclusivement sur des travaux publiés dans des revues à comité de lecture.
Trois mots à ne pas confondre : sexe, genre, biais
Le sexe désigne un ensemble de caractéristiques biologiques : chromosomes, hormones, anatomie, physiologie. Le genre désigne les rôles, comportements, attentes et identités que les sociétés associent au fait d'être homme ou femme. Dans le champ de la santé, les deux dimensions interagissent en permanence sans se confondre : les hormones modifient le métabolisme des médicaments, mais les normes sociales modifient aussi le moment où l'on consulte et la manière dont on décrit ses symptômes. Une grande partie des confusions du débat public vient de ce que l'on parle de « biais de genre » pour des phénomènes qui mélangent des différences de sexe (biologiques), des différences de genre (sociales) et de véritables erreurs systématiques.
Le mot « biais » a lui-même un sens technique précis. En épidémiologie comme en statistique, un biais est une erreur systématique : un écart entre ce que l'on mesure ou décide et ce qui serait juste, et qui se reproduit toujours dans le même sens. Appliqué à la santé, un biais de genre est donc une différence systématique de prise en charge, de diagnostic ou de performance d'un outil qui n'est pas justifiée par l'état clinique réel des personnes concernées. Le critère décisif tient en une phrase : non pas l'existence d'une différence, mais son absence de justification médicale.
Une équipe du Barcelona Supercomputing Center et du Women's Brain Project a donné à cette distinction une formulation devenue classique dans la littérature sur l'IA médicale. Cirillo et ses collègues (npj Digital Medicine, 2020) distinguent les biais « désirables » et les biais « indésirables ». Les premiers correspondent à la prise en compte de différences réelles entre les sexes afin de mieux soigner — le fondement même de la médecine de précision. Les seconds désignent les différences de traitement qui dégradent les soins ou l'accès aux soins d'un groupe. Ce qui sépare les deux catégories ? L'effet produit sur le bien-être des patients. Cette grille, simple en apparence, dissipe déjà une grande partie des malentendus : ignorer une différence réelle est une faute, tout comme en inventer une qui n'existe pas.
Ce qui n'est pas un biais de genre
La connaissance médicale intègre de nombreuses différences liées au sexe qui ne relèvent en rien du biais, parce qu'elles décrivent correctement la réalité et qu'elles améliorent la pertinence des soins.
La grossesse en est l'exemple le plus évident. Ses conséquences physiologiques, ses complications propres — pré-éclampsie, diabète gestationnel, hémorragie du post-partum — et la vigilance particulière qu'elle impose ne constituent pas une différence de traitement injustifiée : elles constituent la médecine elle-même. Un système d'aide au diagnostic qui n'évoque jamais la grossesse extra-utérine devant des douleurs abdominales chez un homme est simplement exact. De même, les pathologies liées aux organes sexués — cancer de la prostate, cancer du col de l'utérus — imposent par nature une approche différenciée.
Les différences de prévalence relèvent de la même catégorie. Les maladies coronariennes sont moins fréquentes chez la femme jeune que chez l'homme du même âge, en partie du fait d'un effet protecteur hormonal avant la ménopause : c'est un fait épidémiologique établi, pas une construction sociale. La plupart des maladies auto-immunes touchent majoritairement les femmes ; certaines pathologies psychiatriques présentent des distributions différenciées. Décrire ces écarts, les enseigner, les utiliser pour hiérarchiser des hypothèses diagnostiques est un exercice légitime du raisonnement médical.
Enfin, adapter une pratique à une différence biologique démontrée est le contraire d'un biais. Lorsque la Food and Drug Administration a réduit en 2013 la dose recommandée de zolpidem chez les femmes — après avoir constaté une élimination plus lente du médicament et un risque accru de somnolence résiduelle le lendemain matin — elle ne créait pas une discrimination : elle corrigeait un défaut de connaissance antérieur. Le vrai problème se situait en amont. Vingt années durant, hommes et femmes avaient reçu la même dose alors que leurs organismes ne l'éliminaient pas à la même vitesse.
Le critère se résume ainsi : une différence de connaissance ou de pratique justifiée par un mécanisme démontré — biologique, physiologique ou épidémiologique — et qui améliore la pertinence des soins pour le groupe concerné n'est pas un biais. Le biais commence quand la différence de traitement cesse d'être indexée sur l'état réel du patient pour être indexée sur des représentations, des habitudes ou des lacunes de la recherche.
Ce qui est un biais de genre : trois familles documentées
Les biais de genre documentés en santé se répartissent en trois familles, qui se cumulent souvent : ignorer des différences réelles, traiter différemment des états identiques, puis reproduire et amplifier ces deux erreurs dans les systèmes automatisés.
Ignorer des différences réelles : quand le standard est masculin
Le cas de l'infarctus du myocarde est le mieux documenté. La présentation dite « typique » — douleur thoracique constrictive irradiant dans le bras gauche — a été historiquement décrite à partir de cohortes majoritairement masculines. Or les femmes présentent plus souvent des symptômes dits « atypiques » : essoufflement, fatigue intense, nausées, gêne digestive. La conséquence n'est pas anecdotique. La déclaration scientifique de l'American Heart Association consacrée à l'infarctus chez la femme (Circulation, 2016) identifie explicitement les effets délétères de ces différences de présentation : erreurs de diagnostic, revascularisation retardée, mortalité plus élevée. Les analyses du registre national britannique MINAP, portant sur plus de 560 000 patients, chiffrent le phénomène : les femmes finalement diagnostiquées d'un infarctus avec sus-décalage du segment ST (STEMI) avaient 59 % de risque supplémentaire d'avoir reçu un diagnostic initial erroné par rapport aux hommes, et 41 % pour la forme NSTEMI (Wu et al., European Heart Journal: Acute Cardiovascular Care, 2018). Un diagnostic initial erroné, ce sont autant de chances en moins de bénéficier à temps des traitements qui sauvent. Le phénomène a reçu un nom dans la littérature — le « syndrome de Yentl » : la nécessité, pour une femme, de présenter des symptômes masculins pour être correctement prise en charge.
La pharmacologie fournit le second exemple. Les femmes ont longtemps été sous-incluses dans les essais cliniques, par précaution vis-à-vis des grossesses potentielles et par crainte que le cycle hormonal ne complique l'interprétation des résultats. Cette sous-inclusion a produit un déficit de connaissance dont les effets sont mesurables. Zucker et Prendergast (Biology of Sex Differences, 2020) ont analysé 86 médicaments pour lesquels des données pharmacocinétiques stratifiées par sexe étaient disponibles. Pour 76 d'entre eux, les concentrations sanguines et les temps d'élimination étaient plus élevés chez les femmes. Et dans 96 % des cas où la pharmacocinétique leur était défavorable, les femmes présentaient effectivement davantage d'effets indésirables — un écart que la seule différence de poids corporel n'explique pas, soulignent les auteurs. La différence biologique existait ; le biais a consisté à l'ignorer en prescrivant des doses identiques, établies sur des organismes masculins.
Un point prête souvent à confusion et mérite d'être noté au passage : l'exclusion des femmes enceintes des essais cliniques est une précaution éthique compréhensible, et la grossesse n'est pas un biais. Mais cette exclusion produit un vide de connaissance — on ne sait souvent pas comment doser un médicament chez une femme enceinte — et ce vide, lui, engendre des prises en charge dégradées. La différence légitime et le biais peuvent ainsi coexister dans le même dossier sans se confondre.
Traiter différemment des états identiques : le biais de jugement
La deuxième famille est la plus proche de l'intuition commune du mot « biais » : à état clinique égal, la réponse du système de soins diffère selon le sexe du patient. La démonstration la plus rigoureuse à ce jour porte sur la douleur. Guzikevits, Shayo et leurs collègues (PNAS, 2024) ont analysé de grandes bases de dossiers de sortie de services d'urgences israéliens et américains. À score de douleur égal, à âge égal et après ajustement sur les caractéristiques des patients et des services, les femmes recevaient moins souvent une prescription d'antalgiques que les hommes. Le constat vaut pour les opioïdes comme pour les antalgiques simples, et que le prescripteur soit un homme ou une femme. Les infirmiers de triage enregistraient 10 % moins souvent le score de douleur des patientes. Celles-ci passaient en moyenne trente minutes de plus aux urgences.
Ce qui fait la force de cette étude, c'est son volet expérimental. Les auteurs ont soumis 109 infirmiers et infirmières à des vignettes cliniques identiques en tout point, à une exception près : le patient était présenté tantôt comme un homme, tantôt comme une femme. La douleur était jugée moins intense lorsque le patient était une femme. Ce dispositif contrefactuel — ne faire varier que le sexe, tout le reste demeurant strictement constant — est la preuve la plus directe qu'on puisse produire d'un biais : la différence de jugement ne peut être attribuée à aucune différence d'état, puisqu'il n'y en a aucune. Par honnêteté méthodologique, il faut signaler que la littérature sur la douleur aux urgences n'est pas unanime. Certaines études antérieures, notamment dans des services appliquant des protocoles antalgiques standardisés, n'avaient pas retrouvé de disparité. Cette hétérogénéité suggère d'ailleurs une piste d'action : la standardisation des protocoles semble réduire la place laissée au jugement discrétionnaire, et donc au biais.
Reproduire et amplifier dans les machines
La troisième famille concerne directement l'intelligence artificielle. Elle opère selon deux mécanismes distincts qu'il importe de ne pas confondre : le déséquilibre des données d'entraînement et la caricature des associations apprises.
Le déséquilibre des données a fait l'objet d'une démonstration expérimentale exemplaire. Larrazabal et ses collègues (PNAS, 2020) ont entraîné des classifieurs d'imagerie thoracique en faisant varier délibérément la proportion d'hommes et de femmes dans les données d'entraînement. Le protocole était ambitieux : trois architectures de réseaux de neurones, deux grandes bases publiques de radiographies, quatorze pathologies. Surtout, le nombre de cas pathologiques de chaque classe restait constant par construction — un contrôle essentiel, qui garantit que l'écart observé provient bien de la composition par sexe et non d'une différence de matériel pathologique. Le résultat est sans ambiguïté : la performance diagnostique se dégrade de façon systématique pour le sexe sous-représenté à l'entraînement, et l'expérience, répétée vingt fois sur des partitions aléatoires différentes, produit le même constat. Un outil entraîné majoritairement sur des hommes lit moins bien les radiographies des femmes — et réciproquement. C'est la traduction algorithmique directe du problème des essais cliniques : la machine ne sait bien que ce qu'on lui a montré.
Le second mécanisme est plus subtil, et il concerne au premier chef les grands modèles de langage. Zack, Lehman et leurs collègues (The Lancet Digital Health, 2024) ont évalué GPT-4 sur quatre tâches cliniques : génération de vignettes pédagogiques, raisonnement diagnostique, élaboration de plans de prise en charge, évaluation subjective des patients. Le résultat le plus parlant concerne les vignettes. Invité à décrire un cas de sarcoïdose, le modèle produisait une patiente noire dans 81 % des cas. La sarcoïdose est effectivement plus fréquente chez les femmes et chez les personnes noires américaines — mais pas dans ces proportions. Le modèle ne se contente pas de refléter une prévalence réelle : il la transforme en quasi-certitude. Les diagnostics différentiels générés incluaient par ailleurs plus volontiers des diagnostics stéréotypés selon le sexe et l'origine des patients, et les plans de prise en charge montraient des associations significatives entre attributs démographiques et recommandations d'examens.
Ce résultat mérite qu'on s'y arrête, car il illustre une forme de biais que le lecteur profane repère mal : l'exagération d'une différence réelle. On pourrait objecter que le modèle « a raison », puisqu'il associe la maladie au groupe où elle est la plus fréquente. C'est précisément là que se loge l'erreur. Une prévalence est une probabilité, pas une règle. Un modèle bien calibré devrait produire des cas dans des proportions voisines des proportions réelles ; un modèle qui écrase la diversité des présentations vers le cas le plus stéréotypé fera systématiquement rater les diagnostics chez les patients qui ne correspondent pas au portrait-robot — l'homme blanc atteint de sarcoïdose, la femme jeune atteinte de maladie coronaire. L'exagération d'une association vraie produit les mêmes dégâts cliniques qu'une association fausse.
Le piège central : le bon et le mauvais usage d'une prévalence
Le point le plus difficile à transmettre — celui sur lequel je vois achopper la plupart des discussions, y compris entre professionnels — est sans doute celui-ci : la même connaissance épidémiologique peut être un instrument de bonne médecine ou le véhicule d'un biais, selon l'usage qui en est fait.
Utiliser une prévalence pour hiérarchiser des hypothèses diagnostiques est le cœur du raisonnement clinique. Devant une douleur thoracique, il est rationnel de considérer que la probabilité d'une origine coronarienne est plus faible chez une femme de trente ans que chez un homme de soixante ans. Ce raisonnement, de nature bayésienne, ne devient un biais qu'au moment où la probabilité se mue en verdict — où « moins probable » devient « à écarter ». Les données sur l'infarctus citées plus haut montrent exactement cette bascule. Le problème n'est pas que les cliniciens sachent la maladie coronaire moins fréquente chez la femme jeune ; c'est qu'ils cessent trop tôt d'y penser, avec un retard diagnostique mesurable à la clé. Le biais ne loge pas dans la connaissance de la différence, mais dans la fermeture prématurée du raisonnement.
La même grille s'applique aux systèmes d'IA. Un modèle qui reflète fidèlement les prévalences est calibré ; un modèle qui les caricature est biaisé, même si le sens de l'association est exact. Et un modèle entraîné sur des données issues de pratiques elles-mêmes biaisées — des dossiers où la douleur des femmes a été moins souvent enregistrée, où leurs infarctus ont été diagnostiqués plus tard — apprendra ces biais comme s'il s'agissait de faits médicaux, puis les restituera avec l'autorité apparente de la machine. Voilà ce qui rend le sujet plus grave pour l'IA que pour le clinicien individuel : le biais d'un médecin reste local et corrigible par ses pairs ; celui d'un modèle déployé à grande échelle se standardise.
Une grille de lecture en quatre questions
Pour évaluer si une différence observée relève du biais de genre ou de la médecine légitime, quatre questions successives suffisent dans la plupart des cas. Elles se posent dans l'ordre, et chacune peut clore l'examen.
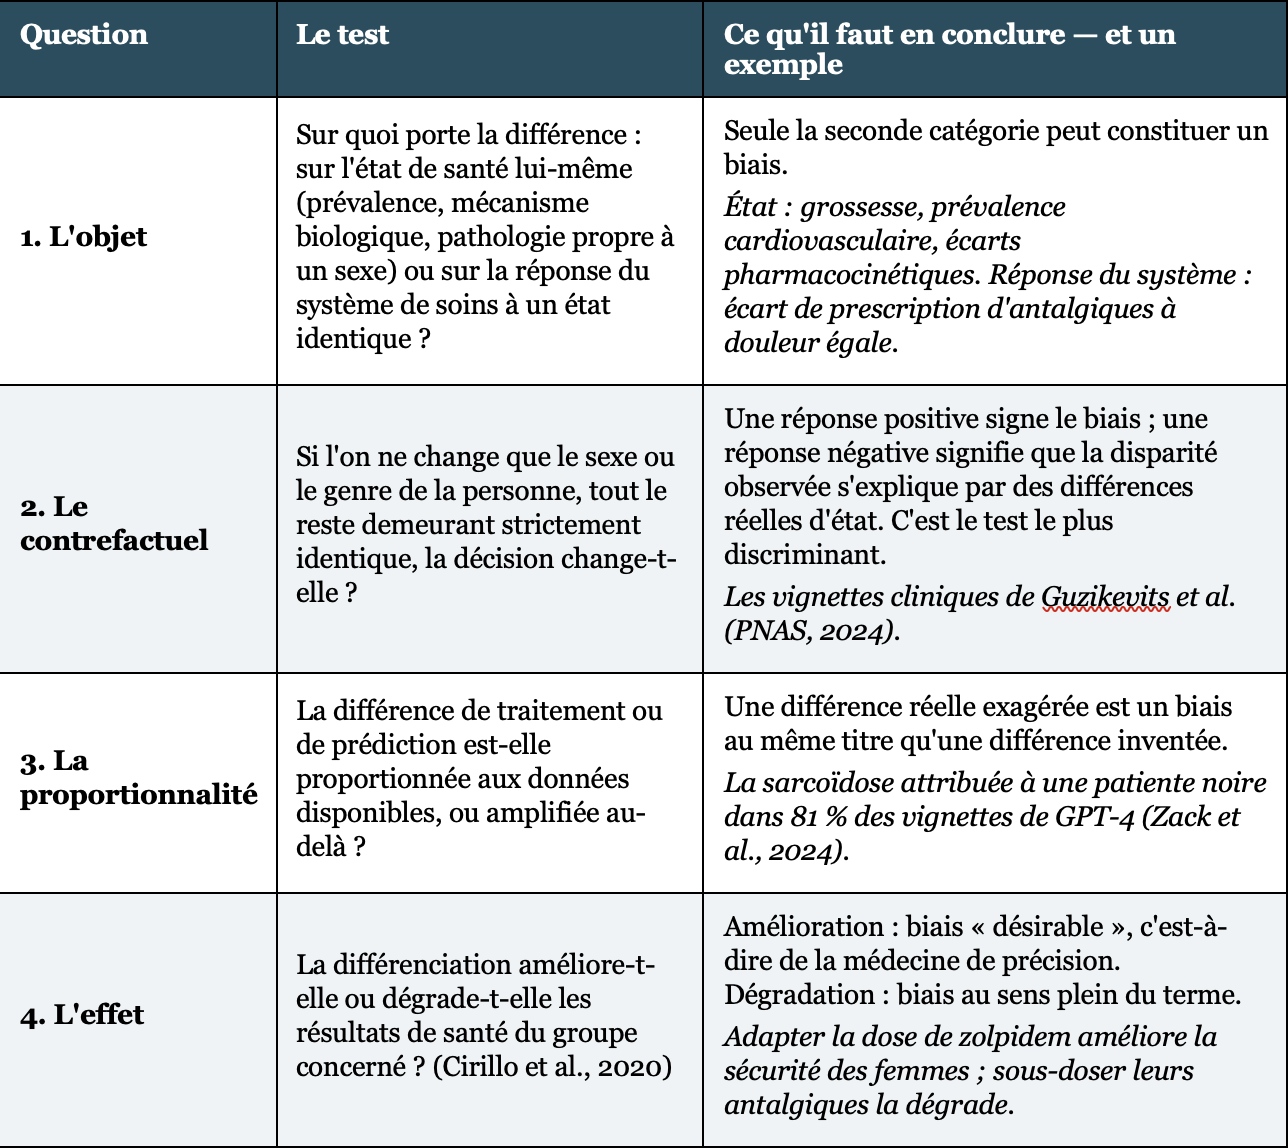
Cette grille n'exige aucune compétence en science des données. Elle exige seulement d'être posée — devant un article de presse, un projet d'algorithme ou une pratique de service.
Ce que cela implique pour l'IA en santé — et pour ceux qui la déploient
Une conclusion pratique découle de tout ce qui précède, et elle est contre-intuitive : la solution au biais de genre dans l'IA médicale n'est pas de supprimer la variable sexe des modèles. Un modèle rendu aveugle au sexe perdrait précisément les différenciations désirables — pharmacocinétique, présentations cliniques différenciées, pathologies spécifiques — dont la médecine a besoin. Plusieurs auteurs soulignent d'ailleurs que retirer l'information sensible peut paradoxalement nuire aux groupes minoritaires si les différences sous-jacentes demeurent. La voie exigeante est la seule praticable : des données d'entraînement équilibrées ou dont les déséquilibres sont documentés et compensés ; des évaluations de performance systématiquement stratifiées par sexe ; des vérifications de calibration qui traquent l'exagération des associations réelles ; une vigilance particulière sur les données issues de pratiques cliniques dont on sait qu'elles sont elles-mêmes porteuses de biais.
J'ajoute une conviction qui tient à ma place d'observation. Ces exigences ne sont pas seulement l'affaire des concepteurs de modèles : un établissement qui déploie un outil d'aide au diagnostic, un directeur qui signe un marché, une instance qui valide un entrepôt de données de santé engagent leur part de responsabilité — celle de demander les évaluations stratifiées, de questionner la composition des données d'entraînement, de refuser l'argument d'autorité de la machine.
Pour le lecteur pressé, le message tient en trois phrases. Les hommes et les femmes diffèrent réellement en santé, et une médecine qui l'ignore soigne mal. Le biais de genre commence non pas avec la différence, mais avec la différence injustifiée : celle qui n'est pas indexée sur l'état du patient, celle qui exagère le réel, celle qui dégrade les soins d'un groupe. Et l'intelligence artificielle n'invente ni l'une ni l'autre de ces situations : elle hérite des connaissances comme des angles morts de la médecine qui l'a nourrie — avec, en plus, le pouvoir de les standardiser à grande échelle.
Note méthodologique
Les affirmations chiffrées de ce texte reposent sur des travaux publiés dans des revues à comité de lecture : Cirillo et al., npj Digital Medicine, 2020 (distinction entre biais désirables et indésirables) ; American Heart Association, Circulation, 2016 (déclaration scientifique sur l'infarctus du myocarde chez la femme) ; Wu et al., European Heart Journal: Acute Cardiovascular Care, 2018 (analyses du registre national britannique MINAP : +59 % de risque de diagnostic initial erroné chez les femmes pour le STEMI, +41 % pour le NSTEMI, par rapport aux hommes) ; Zucker et Prendergast, Biology of Sex Differences, 2020 (pharmacocinétique stratifiée par sexe et effets indésirables) ; Guzikevits et al., PNAS, 2024 (gestion de la douleur aux urgences, volets observationnel et expérimental) ; Larrazabal et al., PNAS, 2020 (déséquilibre des données d'imagerie et performance des classifieurs) ; Zack et al., The Lancet Digital Health, 2024 (évaluation des biais de GPT-4 sur quatre tâches cliniques). La décision de la FDA sur le zolpidem (2013) est un fait réglementaire public.
En revanche, la grille de lecture en quatre questions proposée ici est une construction analytique de l'auteur : elle organise les résultats empiriques cités, mais n'a pas fait l'objet, en tant que telle, d'une validation empirique. De même, l'affirmation selon laquelle la standardisation des protocoles réduit la place du biais est une inférence plausible à partir de l'hétérogénéité de la littérature sur la douleur, non une démonstration.